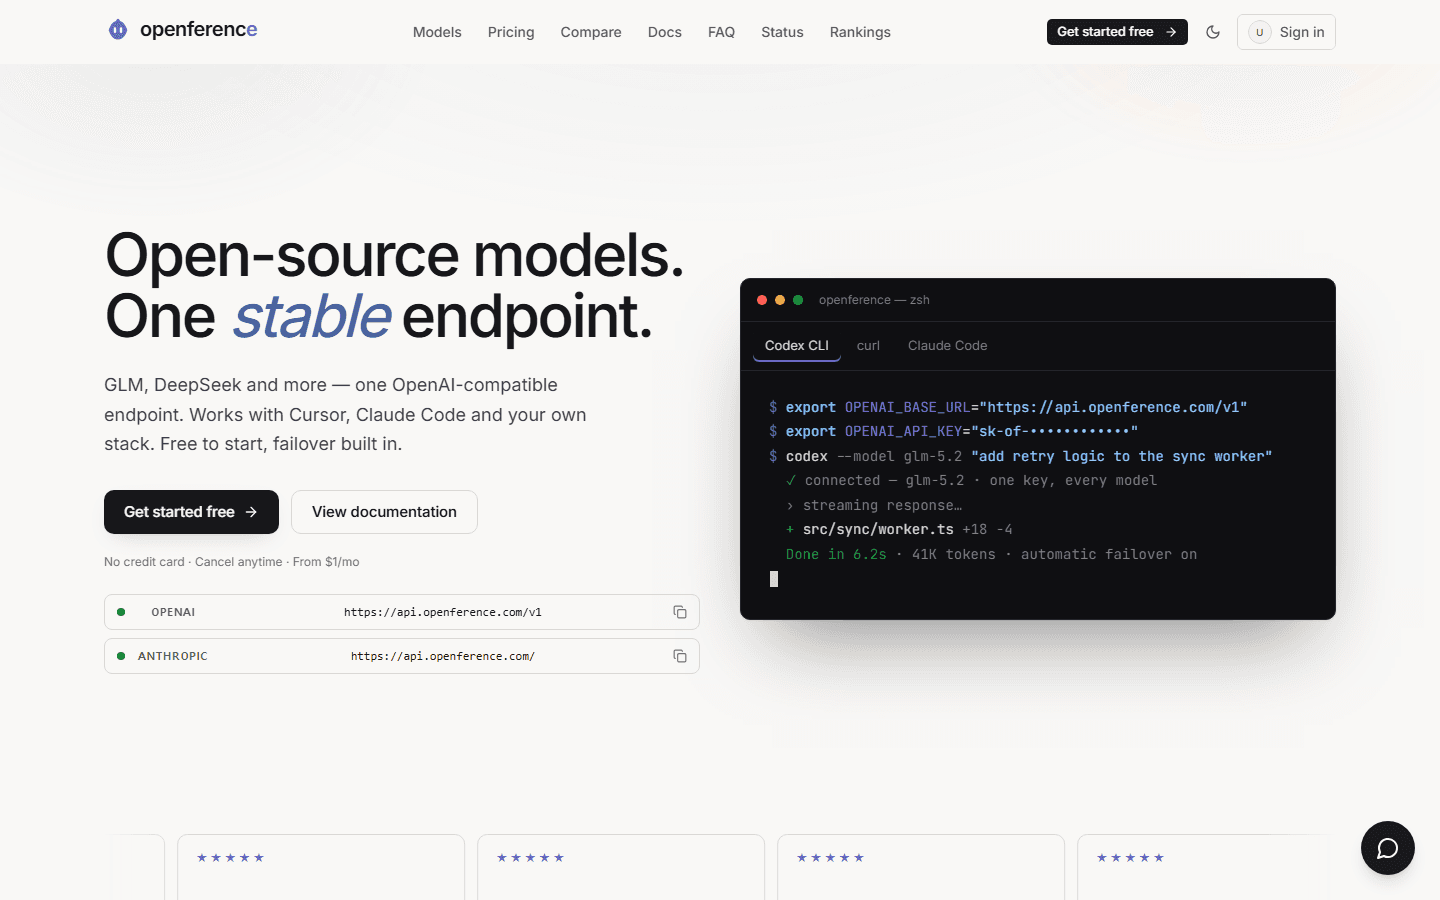
openference.com:套餐看着还行,然后烧掉 10 分 39 秒,报错关掉。
结论
按请求而不是按代币计费,这个思路本身没问题,我也不反对。问题是请求回不来 —— 想了 10 分 39 秒,然后 stream was interrupted。结论:别付钱。
这就是这篇评价的全部。模型是真的,解码速度也正常。钱出去了,时间出去了,结果没回来。
套餐本身不是问题
它按请求数计费,不按代币。一次调用就是一个请求,带 2 千 token 还是 20 万 token 都一样 —— 所以大上下文便宜,海量小调用很贵。Lite 是 15 美元,每 5 小时 400 次、每周 7,500 次;Pro 是 30 美元,800 次和 13,000 次;Max 是 60 美元,1,600 次和 26,000 次。
- 每一档都是每周上限先到。每 5 小时 1,600 次如果连续跑相当于每天 7,680 次,但每周 26,000 次只有每天 3,714 次 —— 真正卡你的是周。
- 15 美元的 Lite 档不含 Kimi 模型。
- 核实时 Max 已售罄。
- 额度用完不会断线 —— 会按套餐折扣的目录价从余额继续扣。
那为什么是警告
上面这些都不是问题。套餐不是骗局。收了钱不还结果才是骗局。默认 thinking 被设成 max,而且是隐藏的,所以一个看起来死掉的请求其实在你看不见的地方推理。有一次马里奥 1-1 的请求,正文 0 字跑了 97 秒,我自己中断的。
同一个 key 上的实测:输入 18,285 token,TTFT 9.6 秒,输出 67 token,其中 58 个是 reasoning。同类请求 DeepSeek-V4-Flash-0731 用 19.7 秒、1,468 token 就答完了。
模型没问题。运营有问题。而你花钱买的是运营,不是模型。
完整数据在骗局板块的 Openference 那篇里。
常见问题
- 套餐本身是问题吗?
- 不是。按请求计费是正常模式,上限也写得很清楚。问题是付过钱的请求不返回结果。
- 能退款吗?
- 按其自身条款订阅不可退款。年付大约便宜 17%,同样是不可退款的条件。
- 模型很差吗?
- 模型是真的,解码速度也正常。同一个 key 上,DeepSeek-V4-Flash-0731 用 19.7 秒、1,468 token 答完了同类请求。
核实过的条款
按请求数计费直接读自提供商的定价页。上面的评价是针对这些数字的判断,并没有把数字重抄一遍 —— 所以两者不可能对不上。
- $15.00
每月 $15 · Lite
每 5 小时 400 次,每周 7,500 次
真正卡住你的是什么: 卡住你的是每周上限,不是 5 小时上限
不含 Kimi 模型
- $30.00
每月 $30 · Pro
每 5 小时 800 次,每周 13,000 次
真正卡住你的是什么: 卡住你的是每周上限,不是 5 小时上限
含 Kimi 模型
- $60.00
每月 $60 · Max
每 5 小时 1,600 次,每周 26,000 次
真正卡住你的是什么: 卡住你的是每周上限,不是 5 小时上限
核实时已售罄
模型 GLM, DeepSeek, Qwen, Llama — Lite excludes Kimi
值得知道
- 每一档都是每周上限先到。每 5 小时 1,600 次,如果连续跑相当于每天 7,680 次,但每周 26,000 次只有每天 3,714 次 —— 真正卡你的是周。Lite 是 1,920 对 1,071,Pro 是 3,840 对 1,857。
- 一次请求就是一次 API 调用,与大小无关。如果你发 20 万 token 的上下文,这是本页最划算的;如果发成千上万个小调用,这是最差的。
- 15 美元的 Lite 档不含 Kimi 模型。如果是为了 Kimi 来的,你需要 30 美元档。
- Max 在核实时已售罄 —— 每一档的名额都是有上限的。
- 额度用完不会断线。会按套餐折扣的目录价从余额继续扣,忙的那一周是花钱,不是停机。
- 提供商的报错和容量问题不计入额度。
- 订阅不可退款。年付大约便宜 17%。
来源: openference.com核实 2026-09-20