openference.com: 모델은 진짜인데, 느리고 자꾸 끊겨요
사이트 리뷰비추천
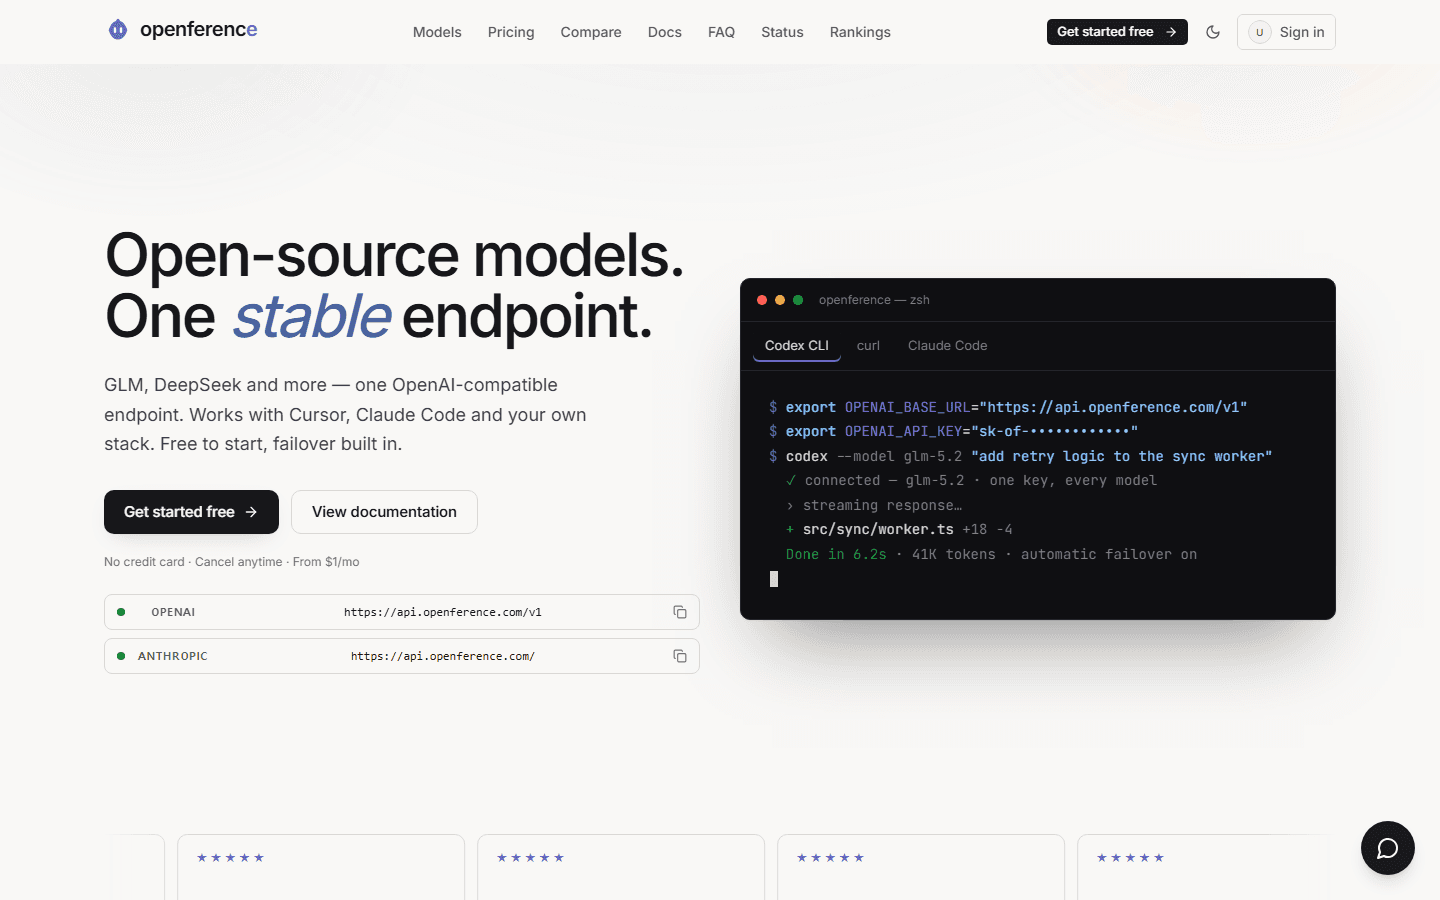
결론
모델은 진짜고 디코딩 속도도 정상이에요. 정상이 아닌 건 돈 내고 돌린 요청이 10분을 끌다가 아무것도 돌려주지 않는다는 점이에요. 추천하지 않아요.
10분 39초 / Error: The model provider's stream was interrupted. Please retry.
리뷰는 이게 전부예요. 모델은 진짜고, 디코딩 속도도 정상이고, 가격도 문제가 아니에요. 문제는 돈 내고 돌린 요청이 10분을 쓰고 빈손으로 돌아온다는 거예요.
같은 키로 모델 3개 × effort 3단계를 전부 재 봤어요. 변수는 모델이 아니라 effort 기본값이에요. GLM-5.3-Flash는 low에서 5.1초 만에 본문이 나와요. high로 올리면 69초가 걸리고, thinking이 출력의 87%를 차지해요. GLM-5.3은 low와 high에서 본문이 아예 안 나와요. 100% thinking만 하다가 length에 걸려요.
| 모델 | effort | 본문 시작 | 전체 | thinking 비중 | 비고 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | low | 5.1s | 8.8s | 0% | thinking 없음 |
| GLM-5.3-Flash | high | 69s | 77s | 87% | low의 약 9배 |
| GLM-5.3-Flash | max | 86s | 99s | 87% | high와 동일 |
| GLM-5.3 | low | 없음 | 64s | 100% | thinking만 하다가 length |
| GLM-5.3 | high | 없음 | 81s | 100% | 마찬가지 |
| GLM-5.3 | max | 79s | 83s | 93% | 본문 나오자마자 length |
| DeepSeek-V4-Flash | low | 20s | 27s | 75% | 쓸 만한 수준 |
| DeepSeek-V4-Flash | high | 없음 | 95s | 100% | thinking에 토큰 전부 소진 |
| DeepSeek-V4-Flash | max | 27s | 32s | 86% | 이번엔 low와 비슷 |
자주 묻는 질문
- 모델이 별로인가요?
- 아니에요. 모델은 진짜고 속도도 정상이에요. 같은 키로 DeepSeek-V4-Flash-0731은 같은 종류의 요청에 19.7초, 1,468토큰으로 답했어요. 문제는 모델이 아니라 모델을 감싼 서비스예요.
- 그럼 돈을 내지 말라는 건가요?
- 지금은 그래요. 모델은 진짜고 요금제도 나쁘지 않아요. 그런데 돈 내고 돌린 요청이 돌아오지 않아요. 이게 고쳐지면 다시 볼 만해요.
다른 사이트 리뷰
댓글
0아직 댓글이 없어요. 익명으로 첫 댓글을 남겨 보세요.